研究紹介
研究領域はデータマイニングと機械学習です。離散的な構造をどう数え、どう比べるかという問いを軸に、次のテーマに取り組んでいます。
- 結晶表面の構造探索(離散構造の列挙、SAT、ベイズ最適化)
- 大規模言語モデルによるテキストの計量分析
- 計算アーカイブズ学
- 公共事業入札データの分析
- 高速な近傍検索と2部グラフからの知識発見
- 離散データ構造間の類似度設計
- 高速な特徴選択アルゴリズムの開発
- 操作ログ、ソーシャルメディア、絡み目不変量の分析
おおむね、いま重心があるものから順に並べています。ただし、どのテーマも手法や問いを共有していて、どこかで終わったというよりは濃淡が変わりながら続いています。
結晶表面の構造探索
結晶成長のモデリングでは、結晶表面にどのような原子配置がありうるかを網羅的に調べる必要があります。これは無限平面上に定義された離散構造の列挙問題であり、同時に、得られた膨大な候補の中から安定な配置を選び出す構造最適化問題でもあります。
この二つの問題に対して、次の二方向から取り組んでいます。
- SAT ソルバーによる制約の検証 表面構造の安定性を判定する経験則である局所電子計数則を論理式として定式化し、充足可能性判定によってその妥当性を検証します。
- ベイズ最適化と第一原理計算の組合せ 密度汎関数理論による計算コストの高い評価を、ベイズ最適化で効率的にサンプリングし、GaN 表面やグラフェン様 BCN 系の安定配置を探索します。
構造探索では、候補どうしの「似ている・似ていない」を測る必要があります。従来から取り組んできた離散構造の類似度設計が、そのまま探索の道具になります。
主な共同研究
- 九州大学 応用力学研究所 寒川義裕氏、草場彰氏: 結晶成長の第一原理計算、デジタルツイン、ベイズ最適化による構造探索
- 堀山貴史氏(埼玉大学)、宇野毅明氏(国立情報学研究所)、 平田耕一氏(九州工業大学): 離散構造の列挙アルゴリズム (科研費 基盤研究(B))
大規模言語モデルによるテキストの計量分析
文学や政治学には、人が読めば判断できるものの、大量かつ一貫した評価が難しい問題が数多くあります。国会会議録や選挙公報、古典中国語テキスト、SNS 上の言説などがその例です。大規模言語モデルを評価器として用い、こうした領域に計量的な分析を持ち込む試みを進めています。
問題は、大規模言語モデルの出力をそのまま指標として使えないことです。出力の安定性や偏りをどう評価し、従来の計量テキスト分析やクラスタリングとどう組み合わせるかが実際の課題になります。
主な共同研究
計算アーカイブズ学
アーカイブズ記述は、資料そのものではなく、資料を生み出す元になる活動のプロセスをコンテクストとして記述するものです。その国際標準である EAD、EAC-CPF、そして新しい RiC (Records in Contexts) は、いずれも階層構造やグラフ構造をもつデータです。
これらの記述を離散構造として扱い、フォンド構造の可視化、コンテクスト構造の抽出、記述標準間の構造比較に取り組んでいます。博士論文で取り組んだ木やグラフの類似度設計という基礎研究の応用と捉えることもできます。
記述標準そのものだけでなく、実際に運用されている記録管理のデータも扱っています。日本の中央政府の行政文書ファイル管理簿を対象に、記録がどのように分類され、どう記述されているかを計量的に分析しています。
RiC については、日本語の入門テキストを公開教材 として公開しています。
公共事業入札データの分析
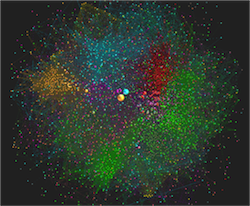
適正な競争入札と談合の判断基準として落札率が広く知られています。しかし、落札率を目的変数とする回帰問題を解くだけでは、必ずしも競争入札の適正性を分析できるわけではありません。
本研究では、入札に参加する業者間のつながりに着目して、その構造の時系列変化や、業者コミュニティの変化を分析しています。図は、ある地方自治体の入札業者間のつながりをネットワークとして可視化したものです。
膨大な入札データに潜む業者の関係性を抽出して分析することで、新しい入札データ分析のための要素技術を開発しています。とくに、同じ入札に排他的に参加している業者グループを発見するための、時系列ネットワーク上のコミュニティ抽出法に取り組んでいます。
主な共同研究
高速な近傍検索
大規模なデータベースから、与えられた点に最も近いデータを見つける最近傍検索は、検索や機械学習の基本操作です。次元が高くなると、厳密な探索は総当たりとほとんど変わらない計算量になってしまいます。
本研究では、各データを短いビット列(スケッチ)に射影し、まず安価なスケッチの比較で候補を絞り込み、そのあとで厳密な距離計算を行う二段構えの手法を扱っています。焦点は、スケッチを何ビットにするか、どの順で列挙するか、絞り込みを何段構えにするか、といった設計にあります。ハミング距離順の連言列挙や、長短二種類のスケッチによる二段フィルタリングを提案しています。
主な共同研究
- 九州工業大学 平田耕一氏、 篠原武氏、樋口直哉氏、今村安伸氏
離散データ構造間の類似度設計
文字列より複雑な木構造、順序構造、グラフ構造といった離散データ構造に関する類似度を設計し、理論的な性質を調べています。また、その成果をデータマイニングや機械学習へ応用しています。
類似度・距離設計
木構造は様々なアルゴリズムで重要な役割を果たし、構文木や進化系統樹、生物の糖鎖構造の表現にも用いられるデータ構造です。
2つの木構造が与えられたとき、この2つの構造はどの程度似ているのでしょうか。その度合いを評価するための指標(類似度や距離)は、一通りではありません。
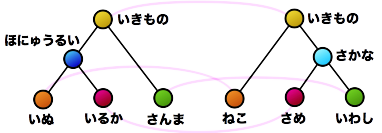
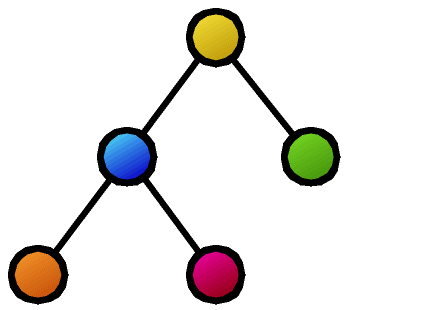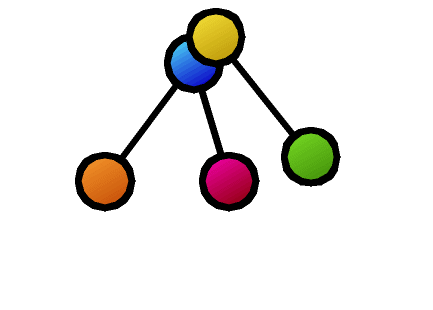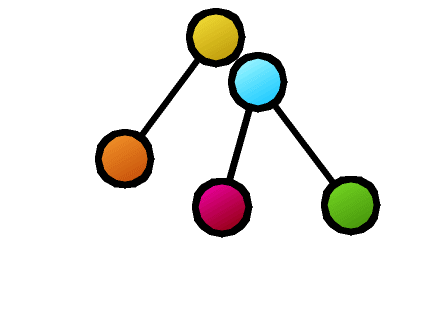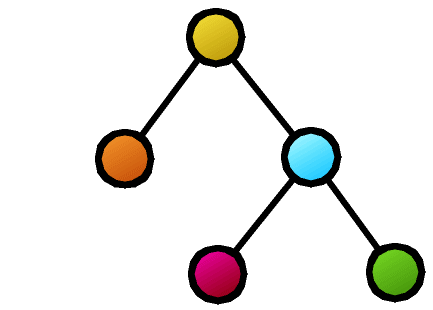
もっとも粗い評価の方法は、2つの構造が完全一致しているか否かを問うものです(同型判定)。木構造の同型判定は効率のよいアルゴリズムが知られています。しかし、多少の不一致は許容して、どの程度似ているのかを評価する問題は
- いろいろな類似度や距離の定義が考えられる
- 一般には計算がとても大変(例えば、無順序木に対する(あるクラスの)木の編集距離計算問題はNP完全)
といった理由から、そう簡単ではありません。広く用いられている編集距離は、 1つの構造をもう一方の構造に書き換えるための編集操作の最小コストにより定義されます。本研究では、明確な基準もないまま乱立していた様々な木の編集距離アルゴリズムや類似度概念を整理し、その相互関係を明らかにしました。
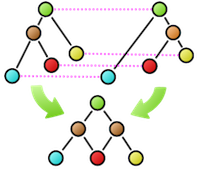
また、木の比較に関連するごく基本的な性質も意外と知られていません。たとえば、図の2つの木の類似度計算の結果、破線で結ばれたノードの対応がとれたとします。この対応したノードを重ね合わせて、各々の木の上下関係を保ったまま、新たに合成木(supertree)を作ることはできるでしょうか。この例では、赤のノードが合流点となり木構造が保てなくなってしまいます。合成後に木構造となるようなノード対応の取り方の必要十分条件は、我々の研究により、はじめて明らかになりました。
類似度・距離の設計については、主に次の2つの観点から取り組んでいます。
- 最適化問題
- 共通部分の最大化(最大共通部分木問題)や不一致部分の最小化(木の編集距離問題)として類似度・距離を設計します。メリットは、計算結果として構成的に、どの部分が似ているのかがわかることです(図では2つの木構造間をつなぐ線として表現してあります)。
- 数え上げ問題
- 共通する部分構造の数え上げ。数え上げ問題として類似度・距離を計算することのメリットは、局所的な類似性を汲み取ることができること、必ずしも構成的に計算する必要がないこと、木構造の分類学習(機械学習における木カーネル設計)にすぐに適用できることです。
これらの基礎研究を「がん由来の糖鎖構造の分類学習」や「時系列コミュニティ階層構造の分析」等に応用しています。
主な共同研究
-
学習院大学 申吉浩氏:
- 様々な木の編集距離の一般化と、理論的な体系づけ、木カーネル設計への応用
- 離散データ構造のカーネル設計の理論
- 九州工業大学 平田耕一氏: 木の編集距離アルゴリズムのクラス階層と計算量の対応
- 京都大学 山本章博氏: 木の編集距離アルゴリズムと新しい木の距離指標の開発
-
東京電機大学 前田英作氏:
- 伊勢型紙デジタルアーカイブ(立命館大学ARCとの共同研究)
高速な特徴選択アルゴリズムの開発
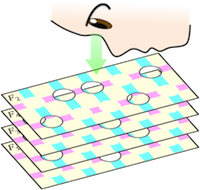
特徴選択は、膨大な属性を持つデータから目的に応じて必要な属性のみを取り出す問題です。データマイニングや機械学習では、重要な基本問題です。
本研究では、離散と連続をつなぐ面白い部分問題を含んだカテゴリカルデータの特徴選択問題に着目し、既存のアルゴリズム中で最も高性能なCWCの理論的な性質の解析と、アルゴリズムの改良、および応用に取り組んでいます。CWCは特徴選択問題を、一種の集合被覆問題として定式化し、貪欲法により特徴を抽出します(図はアルゴリズムのイメージ)。
CWCはとてもシンプルな評価指標を用いて特徴を残すか否かを決定しているにもかかわらず、様々なベンチマークによって実験的にとても高い性能を示すことがわかっています。その性能の良さを理論的にも裏付けるための解析に取り組んでいます。
また、このアルゴリズムを、機械学習の前処理だけでなく、膨大なドキュメントからの高速なトピック語抽出にも応用しています。
開発したソフトウェア
- sCWC: 巨大なスパースデータに対応した高速な特徴選択器です。Scalaで実装しています。
主な共同研究
- 学習院大学 申吉浩氏
コンピューターログからのユーザー行動推定
コンピューターのログ情報、なかでもアクティブウインドウの遷移データを用いて、ユーザーの行動を推定しました。
ウインドウの遷移は背後にある仕事によって生成されると仮定し、隠れマルコフモデルでログを分節化します。こうして抽象化された仕事単位からユーザごとに状態遷移図を作り、それをグラフ構造とみなして、グラフカーネルとカーネル主成分分析により、仕事の進め方が似通ったユーザをクラスタリングしました。アイデアは単純ですが、実際の業務とも対応する解釈しやすい結果が得られました。ほかに、ウインドウ切替の統計的な特徴から勤怠状況を判別する分析も行いました。
故 安田浩氏(東京電機大学 元学長)との共同研究でした。
インフルエンザウイルスの遺伝子変異分析
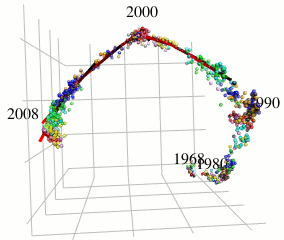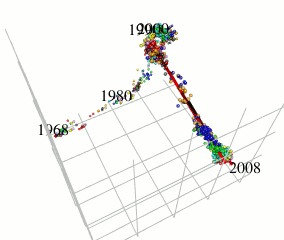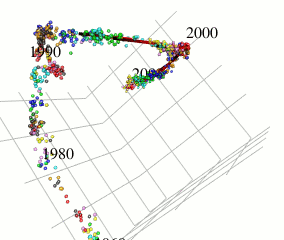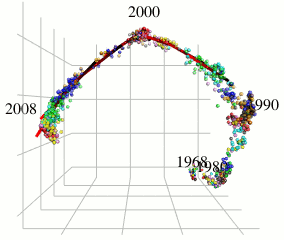
世界的な流行を引き起こすA型インフルエンザウイルスに着目し、そのアミノ酸配列データから抗原の連続変異モデルを構築することを目的とした研究です。北海道大学人獣共通感染症リサーチセンターの伊藤公人氏らによる変異予測や共変異パターン抽出の研究とは異なるアプローチを取りました。
既存研究ではインフルエンザウイルスのヘマグルルチニン遺伝子に対応するアミノ酸配列の変異をハミング距離空間内で観察することにより変異予測を行っています。これに対して、本研究ではハミング距離空間のもつ性質を保ったまま取り扱いの容易なユークリッド距離空間での計算が可能となるようなアミノ酸記号空間の(低歪み)埋め込みを用い、局所的に疎主成分分析を用いることにより、インフルエンザウイルスの進化方向のみの成分を取り出しました(図参照)。これにより、既存手法の予測性能を改善することができました。
問題設定と研究テーマは、北海道大学 人獣共通感染症リサーチセンターの伊藤公人氏から提供して頂きました。
ソーシャルメディアからの時系列トピック抽出
Twitterやブログ、ショッピングサイトの評価書込みといった時系列データから、ユーザのニーズの変遷を抽出する研究です。自然言語処理のトピック抽出法のほかに、ネットワークの階層的コミュニティ抽出法と木の編集距離を組み合わせた方法など、さまざまな手法を用いました。
千葉商科大学の橋本隆子氏との共同研究で、ブログからの東日本大震災後の被災者のニーズ変化の時系列解析などを行いました。この流れは、後続研究である大規模言語モデルによるテキストの計量分析に続いています。
絡み目不変量の高速な計算
絡み目の不変量の一つであるミルナー不変量の、現実的かつ効率的な計算方法の開発を目的とした研究です。与えられた2つの絡み目が同値であるかどうかを判定し、絡み目を分類する絡み目の「位置の問題」に関する研究は、位相幾何学の一分野である結び目理論の重要な課題の1つです。同値判定において鍵となる絡み目不変量の1つであるミルナー不変量はジョン・ミルナーよって1954年に提案されました。ミルナーによって提案されたミルナー不変量を計算するアルゴリズムは非常にシンプルなのですが、計算過程で生成される式の大きさが膨大であるため、近年まで実計算による研究は殆ど行われていませんでした。
ミルナー不変量の計算では変数列が非可換です。本研究では、非可換な変数列が文字列とみなせることに着目し、高効率の文字列アルゴリズムをミルナー不変量の計算に適用しました。とくに、九州工業大学の坂本比呂志氏らが研究を進めている 文法圧縮アルゴリズムを用いて、効率的な計算アルゴリズムを共同で開発しました。
文法圧縮技術を用いると、たとえば、ミルナー不変量計算の過程で生成される長さ約300万変数の単項式(300万文字)を、約1600文字まで圧縮することができます。通常の文章を対象とした一般の圧縮とは桁違いの圧縮率です。文法圧縮アルゴリズムにより、共通計算をくくりだすことにより、少メモリーでかつ高速なミルナー不変量の計算が実現できました。
早稲田大学の安原晃氏との共同研究で、この計算ツールの結果をもとに、絡み目の性質に関する論文が書かれました。
その他のテーマ
- 分野間データ利用における集団照合手法 — 個人情報保護、精度維持、汎用性を同時に満たす照合手法の探求(科研費 基盤研究(C)、代表: 吉浦裕氏)
- 大規模SNS上の話題の構造化による集合行動解析(科研費 基盤研究(B)、代表: 橋本隆子氏)
- 伝統文様のアノテーション自動化(伊勢型紙デジタルアーカイブ)